それは希望であると同時に問題でもあります。AIはあなたのチームが知っていることを知りません。知っているのは、あなたのチームが記録したことだけです。そして、その情報源が最新であろうと2年前に古びたものであろうと、見つけたものを何であれ同じ流暢な自信をもって教えます。
重要な変化は、AIがあなたの社員を教えられるようになったことではありません。あなたのドキュメントが、社員が学ぶ元となるものになった、ということです。
この記事は、AIがループに加わったときに従業員の学び方とチーム内での知識の流れ方がどう変わるのか、そしてそのどれかが機能するために足元で何が成り立っていなければならないのかについてです。
重要なポイント
- トレーニングにおけるAIの真のレバレッジは、コンテンツ生成ではありません。それは適応性と、業務の流れの中での即時の知識検索であり、そのどちらもあなたの既存の情報源の上で完全に動きます。
- トレーニングは、予定して行うイベントから、必要な瞬間に届けられる答えへと移り変わりつつあります。これは、教室型トレーニングの大半を静かに無駄にしている忘却曲線を回避します。
- パーソナライズされた学習は、その土台となるものが何であれ増幅します。誤った、あるいは古い情報源に向ければ、最も行動に移しやすい人に、間違ったことを効率よく教える仕組みを作り上げたことになります。
- AIコパイロットの失敗のパターンは、自信に満ち、体裁の整った、間違った答えです。正確さは今やモデルの問題ではなく、ガバナンスの問題です。
- 目標はAIにあなたのチームを教えさせることではありません。あなたのチームの知識を、教える価値のあるものにすることです。
職場トレーニングにおけるAI
歴史の大半を通じて、職場のトレーニングはイベントでした。人を集め、オンボーディング週間や年次モジュールの間にコンテンツを浴びせ、そのうち十分な量が、必要になる日まで残ることを願うのです。
居心地の悪い真実は、学習科学が1880年代から――ヘルマン・エビングハウスが初めて忘却曲線を記述したときから――知っていることです。ひとまとまりで教えた内容の大半は、何かが補強しない限り数日のうちに消えていきます。イベント型のトレーニングはその曲線と戦い、たいてい負けます。
予定されたトレーニングからリアルタイムのガイダンスへ
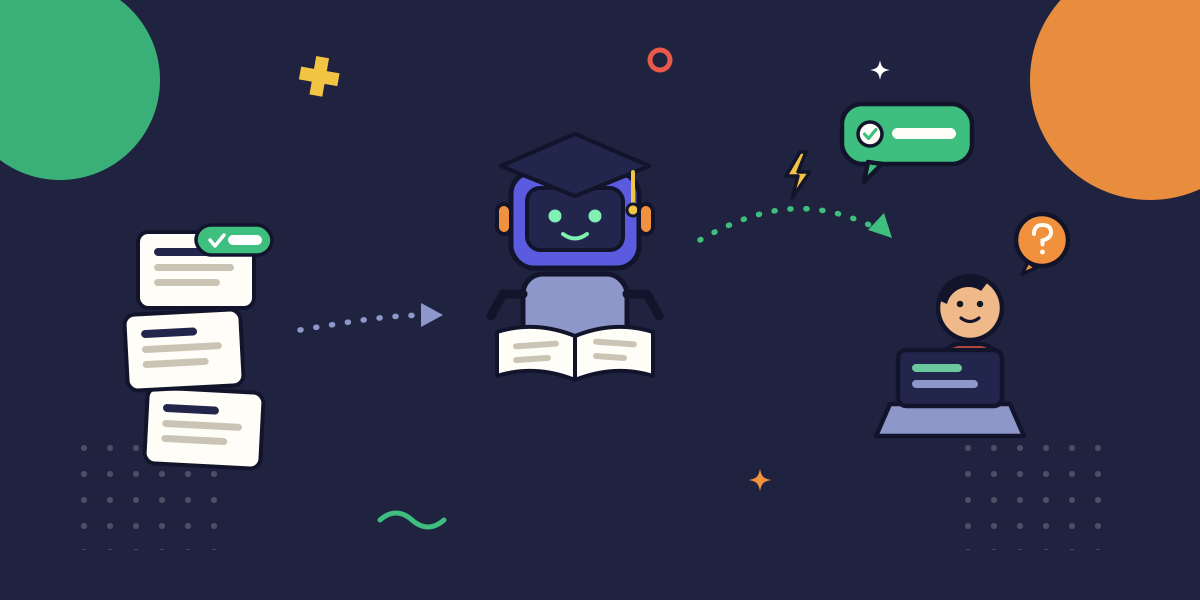
AIは、教える行為を必要な瞬間へと移すことで、問題の形そのものを変えます。新しいエージェントに、オンボーディングから3週間後に顧客の多要素認証のリセット方法を思い出すよう求める代わりに、AIアシスタントはチケットが届いたその瞬間に、すでに作業が行われているツールの中でその質問に答えます。レッスンは必要とされるちょうどそのときに届きます。トレーニングはコースではなく、業務の流れの中での検索になります。
ここでは2つの能力がほとんどの仕事を担います。1つ目は業務の流れの中での検索です:関連する手順、ポリシー、または答えを、要求に応じてナレッジベースから引き出すコパイロット。2つ目は適応的な提供で、これは後ほど扱います。この2つが組み合わさることで、トレーニングと実際の作業の境界線が曖昧になります。
なぜオンボーディングが最初に変わるのか
オンボーディングは、これが最初に、そして最も目に見える形で現れる場所です。新入社員の最初の1か月は、必要な瞬間が長く連なったものだからです。AIが生成するステップバイステップのオンボーディングガイドについては別途扱いますが、同じアプローチはオンボーディングをはるかに超えて、従業員が行うあらゆるタスクへと広がります。
トレーニングはかつて、修了するものでした。今ではそれは業務の背後で静かに動き続けており、問いはもはや、社員がそれを受講したかどうかではありません。社員の質問に答えているものが、真実を伝えているかどうかです。
AIが生成するドキュメント
ここで、物語の2つの半分がつながります。AIが学習し、検索する元となる知識は、ますますAIが生み出しを手伝った知識になっています。かつて作成に何時間もかかったドキュメント、SOP、ガイドが、今ではスクリーン録画やラフなキャプチャから数分で下書きできます。AIがどのようにドキュメントを生成するかと、AI生成ドキュメントのROIについては別途扱います。ここでは、それらのドキュメントが存在するようになった後に何が起こるかに焦点を当てます。
トレーニングと知識共有にとって重要なのは、二次的な効果です。ドキュメントの作成が90〜120分からわずか8〜15分に下がると、情報源を最新に保つことは、チームが後回しにする面倒な作業ではなくなります。検索の上に築かれたトレーニング層にとって、最新の情報源こそがすべてです。
AIが生成するドキュメントは、単なる執筆の近道以上のものです。それは、AIが後に教えるすべてのものの供給線になります。これはドキュメントを記録管理の作業から、イネーブルメント(成果を引き出す)機能へと変えます。従業員が受け取るあらゆる答えの質が、その背後にあるドキュメントの質に左右されるからです。
パーソナライズされた学習
適応的な提供は2つ目の能力であり、その可能性が最も興味深く、そして最も過剰に売り込まれる領域です。
AIが変えるもの
パーソナライズされた学習とは、道筋がその人に合わせて調整されることを意味します:すでに理解していると示したことは飛ばし、つまずいているところでは速度を落とし、教材を集団ではなく個人に合わせて並べ替えます。
優れたインストラクショナルデザイナーは、これを何十年も望んできました。習熟度に基づく進行や間隔反復は、新しい発想ではありません。AIが変えるのは理論ではありません。それは、フラッシュカード式の暗記だけにとどまらず、実際のワークフロー全体にわたって、それらの発想を1対1で大規模に届ける能力です。
企業のL&Dでは、これは、10年のベテランが自分でも教えられる基礎を延々と受けさせられるのをやめ、代わりに彼女にとって本当に新しい2つのポリシー変更に焦点を当てる、コンプライアンスや製品トレーニングのモジュールを意味するかもしれません。コンタクトセンターでは、すべてのエージェントを同じカリキュラムに通すのではなく、エージェントが実際に苦戦しているコールの種類を狙い撃つ適応的なトレーニングを意味します。
パーソナライズは情報源を増幅する
パーソナライズには、人がよく忘れる性質があります:それは土台となるものが何であれ増幅するのです。まさに適切な教材を、まさに適切な人に、まさに必要とするその瞬間に届けるシステムは、強力な増幅装置です。その増幅装置を誤った、あるいは古い情報源に向ければ、より良いトレーニングを作ったことにはなりません。最もそれをすぐに行動に移しやすい人に、間違ったことを教える、可能な限り効率的な方法を作り上げたことになります。
パーソナライズされた学習の要点は、パーソナライズそのものではありませんでした。それは、正しい知識を、正しい頭に、正しいタイミングで届けることであり、「正しい知識」こそが要となる言葉です。情報源を変えれば、答えが変わります。それも大規模に、全員にとって。
リスクと課題
トレーニングにおけるAIへの定番の反論は、それが誇大宣伝だというものです:ありきたりのコンテンツ、幻覚による答え、測定可能な学習成果の欠如。その反論は半分正しく、どちらの半分なのかを具体的にする価値があります。なぜなら、本当のリスクは懐疑派が通常挙げるものではないからです。
自信に満ちた間違った答え。確信のない人間の専門家は「確認させてください」と言います。AIコパイロットはそうしません。最も近い一致のドキュメントを取り出し、流暢で権威ある文章に仕立てます。そのドキュメントが古ければ、モデルは間違った答えを、公式に聞こえるものへと洗浄したことになります。それを信じたエージェントは、その誤りをそのまま顧客に渡してしまいます。
それはドキュメントが何もないよりも悪い状態です。空のナレッジベースは人々に人間へ尋ねさせますが、自信をもって間違ったナレッジベースは、人々が尋ねるのをやめさせてしまいます。AIトレーニング層における正確さは、モデルの品質の問題ではありません。情報源の品質の問題です。
信頼できる情報源の曖昧さ。ほとんどのチームは、あるタスクに対して唯一の正典となる手順を持っていません。3つ持っているのです:wikiにある公式のもの、シニアが実際に従っているバージョン、そして古いチケットからまだリンクされている時代遅れのもの。人間は死んだものを無視することを学びます。AIは学びません。
AIが検索するとき、それは選びます。そして、どのバージョンをなぜ選んだのかを、あなたはめったに知りません。ガバナンス、つまり唯一の正しい情報源が何かを決め、それ以外のすべてを廃止するという地味な作業こそが、どのデモも見せてくれない、AIトレーニングの前提条件です。
過剰なパーソナライズはメンタルモデルを蝕む。常に次の正確なステップだけを手渡され、その背後にある理由を決して渡されない学習者は、従うことが非常に得意になり、理解することが非常に苦手になります。「なぜ」のモデルを一切構築しないため、システムが予期しなかった例外に対処できません。
最も効率的なトレーニングの道筋は、スクリプトが尽きてもなお考えられる人を生み出す道筋とは限りません。
スキルの萎縮は、能力を人からツールへと移す。コパイロットが常に答えるなら、人々はかつて問題に苦しみながら培ってきた内なる専門性を築くのをやめます。それは、ツールが間違うか使えなくなる日までは問題ありません。しかしその日、組織の能力が、チームの誰も完全には理解していないシステムへと移ってしまっていたことに気づくのです。
知識は共有されませんでした。あなたには見えないどこかに集約されたのです。
これらのリスクはいずれも同じ根に行き着き、その解決策も同じです。AIトレーニング層の価値は、その足元にある素材の信頼性によって上限が決まります。そのため、最もレバレッジの高い仕事はAIツールを選ぶことではなく、情報源となる手順を正しく整えることです:タスクごとに1つの正典バージョン、明確なオーナー、目に見える最終確認日、そしてそれらを最新に保つプロセス。
それはAIのプロジェクトではありません。ドキュメントの規律であり、上にモデルが載っていようといまいと、良い手順を生み出すのと同じものです。信頼できる情報源の手順を構築するための7ステップのフレームワークが、出発点として最適です。
あなたの当て推量で訓練されたAIは、チーム全体に、一人では決してできなかったほど速く、より大きな自信をもって当て推量することを教え込みます。情報源を正せば、その同じシステムは、あなたがこれまで持った中で最高のトレーナーになります。
AIによるナレッジマネジメントの未来
十分に先を見れば、ナレッジマネジメントはあなたが出向く場所ではなくなり、あなたのところへやってくるものになります。その軌道はすでに見えています。
ナレッジベースを検索する代わりに、あなたはそれに答えてもらいます。ドキュメントが古くなっていることに気づく代わりに、あなたは知らされます。顧客がぶつかって初めてギャップを発見する代わりに、システムは今月100人が、まともな答えのない質問をしたことを知らせます。
ナレッジマネジメントは能動的で対話的なものになり、この分野の最前線は、ドキュメントを整理することから、知識を捉え、それを正直に保つことへと移ります。それはプロセスドキュメントにおけるより大きな変化の一部です。トレーニングと知識共有こそ、その変化が最初に現れる場所です。そこが知識の消費される場所だからです。
ここが、腹に落としておく価値のある部分です。誰もが同じモデルを借りることになります。競合他社がチームのトレーニングに使う最先端のAIは、あなたが自分のチームのトレーニングに使えるものと同じで、ほぼ同じ価格で、ほぼ来四半期には手に入ります。モデルは堀ではありません。違いはコーパスにあります:あなたの知識が捉えられ、最新で、管理され、そしてシステムが実際に使える場所に書き留められているかどうかです。
だからこそ、本当の仕事は誇大宣伝が示唆するものの正反対にあります。目標はAIにあなたのチームを教えさせることではありません。あなたのチームの知識を、教える価値のあるものにすることです。それができれば、AIは戦力の増幅装置になります。それを飛ばせば、AIはあなたの最悪のドキュメントをスケールさせる、非常に雄弁な手段になります。
ですから、AIがあなたのチームに何を教えられるかを尋ねる前に、もっと難しい問いを立ててください。もしシステムがあなたのチームの書き留めたすべてを読んだら、それは真実を学ぶでしょうか?
その答えを「はい」にできれば、AIはあなたがこれまで雇った中で最高のトレーナーになります。「いいえ」のまま放っておけば、あなたは自分自身の悪い当て推量が広がるのを自動化したことになります。
知識こそが、常に肝心だったのです。AIは、それを正しく整えることの賭け金を引き上げただけです。